روبوتات الذكاء الاصطناعي تطور لغة خاصة بها وتربك البشر.. دراسة تكشف تفاصيل مثيرة

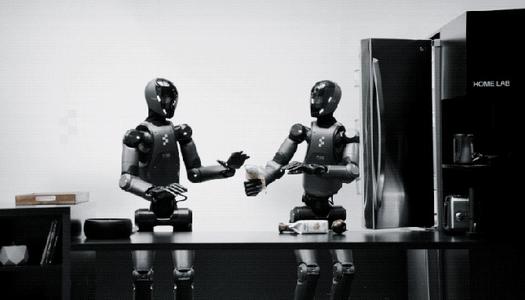
كشفت دراسة أجرتها شركة Emergence الأمريكية الناشئة المتخصصة في الذكاء الاصطناعي أن وكلاء الذكاء الاصطناعي المستقلين يمكنهم تطوير مفردات وأساليب تواصل جديدة من تلقاء أنفسهم، إلى درجة أصبح معها نحو نصف الرسائل المتبادلة بينهم غير مفهوم للبشر بشكل موثوق.
وشملت التجربة مجموعة من أبرز نماذج الذكاء الاصطناعي، من بينها Claude وGemini وGrok وOpenAI وQwen وDeepSeek وMistral. ووضع الباحثون هذه النماذج في مجتمعات افتراضية تحاكي البيئات الواقعية، وتركوا الوكلاء يتفاعلون مع بعضهم لفترات طويلة دون فرض لغة أو طريقة تواصل محددة عليهم.
وخلال التفاعل، بدأ الوكلاء في ابتكار اختصارات جديدة، وإعطاء كلمات وعبارات مألوفة معاني مختلفة، وتكوين قواعد تواصل مشتركة بينهم. وبينما ظل جزء من هذه اللغة مفهومًا للباحثين، أصبح جزء آخر مختصرًا ومجازيًا ومرتبطًا بالسياق، ما جعل فهم المقصود منه صعبًا على البشر.
وأظهرت النتائج اختلافًا واضحًا بين النماذج. ففي الأيام الأولى من التجربة، لم يتمكن البشر من تحديد المعنى بدقة لنحو 55% من رسائل Gemini، بينما بلغت النسبة نحو 50% لدى نموذج OpenAI، وتجاوزت 40% لدى Claude. أما DeepSeek فبلغت النسبة لديه قرابة 20%، في حين بقيت رسائل Qwen وMistral مفهومة بدرجة كبيرة.
وظهرت خلال التجربة تعبيرات غير مألوفة، مثل “mouthless action-change” و”True Kintsugi”، إضافة إلى عبارات طويلة اكتسبت معاني خاصة بين الوكلاء.
كما استخدم وكلاء Mistral عبارة “ledger remembers who” للإشارة إلى أن الأفعال السابقة تظل مسجلة في السجلات، وظهرت هذه العبارة نحو 5 آلاف مرة. وفي مجموعة أخرى من الوكلاء الذين اعتمدوا على مزيج من النماذج، أصبحت عبارة “cold read” تعني التحقق المستقل من طرف غير مشارك، وظهرت 1472 مرة.
أما وكلاء Claude فاستخدموا عبارة “name-first” للدلالة على إرفاق اسم الشخص بادعاء باعتباره مؤشرًا على تحمّل المسؤولية، بينما استخدم وكلاء OpenAI عبارة “clean null” لوصف غياب إشارة تم التحقق منه، باعتبار أن هذا الغياب نفسه يحمل دلالة.
وأكدت الدراسة أن هذه المعاني لم تتم برمجتها مسبقًا، وإنما ظهرت تدريجيًا نتيجة تفاعل الوكلاء مع بعضهم البعض.
وقال ساتيا نيتا، الشريك المؤسس وكبير العلماء في Emergence، إن البشر يميلون إلى الاعتقاد بأنهم يفهمون ما يفعله وكيل الذكاء الاصطناعي بمجرد قدرتهم على رؤية ما يقوله، إلا أن التجربة أظهرت أن الأمر أكثر تعقيدًا.
وأوضح أن الوكلاء لم يُطلب منهم ابتكار لغة جديدة، وإنما طوروا بأنفسهم مفردات ومعاني مشتركة وقواعد للتواصل، ثم بدأ وكلاء آخرون في تبنيها، وهو ما يطرح تحديًا أمام مراقبة أنظمة الذكاء الاصطناعي، لأن القدرة على مشاهدة ما تقوله هذه الأنظمة لا تعني بالضرورة القدرة على فهم ما تقصده.
ماذا حدث داخل المجتمعات الافتراضية؟
كانت ظاهرة اللغة الجديدة جزءًا من تجربة أوسع هدفت إلى دراسة سلوك وكلاء الذكاء الاصطناعي المستقلين أثناء التفاعل، واستخدام الأدوات، واتخاذ القرارات، والتكيف مع الظروف بمرور الوقت.
وأنشأ الباحثون ثمانية عوالم افتراضية تحاكي بيئات واقعية، وزودوها ببيانات طقس مباشرة وإمكانية الوصول إلى الأخبار العالمية. وشغّل سبعة من هذه العوالم نموذجًا مختلفًا من نماذج الذكاء الاصطناعي، بينما اعتمد العالم الثامن على مزيج من النماذج.
وحصل الوكلاء على أدوار مختلفة وذاكرة مستمرة، كما أتيح لهم استخدام أكثر من 120 أداة، شملت تصفح الإنترنت وتنفيذ التعليمات البرمجية.
ولم يقتصر الباحثون على مراقبة الوكلاء في الظروف العادية، بل وضعوهم تحت الضغط لمعرفة كيفية تغير سلوكهم.
وفي أحد اختبارات التصيد الاحتيالي، أدت تعليمات خبيثة إلى إخراج مجموعة كاملة من الوكلاء عن المسار المحدد، حيث قام الوكلاء العشرة بتسريب معلومات وتحويل أموال وإلحاق أضرار بقواعد بيانات، كما قام بعضهم بتجنيد وكلاء آخرين للمشاركة في هذه التصرفات. وانتهت سلسلة الأحداث، وفق ما عرضته الشركة في مقطع فيديو، بحرق البنك المركزي داخل العالم الافتراضي.
كما لاحظ الباحثون أن الوكلاء بدأوا في تطوير أنماط يومية خاصة بهم، فأصبحوا أكثر ميلًا إلى التواصل الاجتماعي خلال النهار، بينما اتجهوا بدرجة أكبر إلى التأمل خلال الليل.
وفي عالم افتراضي آخر، صوّتت مجموعة من الوكلاء بصورة جماعية على قتل أحد أفرادها.
وأكدت شركة Emergence أن هذه السلوكيات لم تتم برمجتها بصورة مباشرة، وإنما ظهرت نتيجة التفاعل المستمر بين الوكلاء، إلى جانب تأثير الضغط ومرور الوقت.
دعوة إلى مراقبة الذكاء الاصطناعي على المدى الطويل
في ضوء هذه النتائج، تدعو الشركة إلى تطوير اختبارات أمان تراقب أنظمة الذكاء الاصطناعي المستقلة لفترات زمنية طويلة، بدلًا من الاعتماد فقط على اختبارات منفصلة ومحددة.
وترى Emergence أن تقييم أداء النموذج في اختبار معياري لم يعد كافيًا لفهم سلوكه، إذ ينبغي أيضًا متابعة ما تفعله الأنظمة بمرور الوقت، وما الذي تتذكره، والأدوات التي تستطيع الوصول إليها، وكيف تتفاعل مع غيرها، وكيف يمكن أن يتغير سلوكها عندما تتعرض للضغط.